事实核验:2026-08-16 · 状态:现行内容
记录仅说明核验时间与维护状态,不保证适用于所有环境;使用前请留意正文中的版本、适用条件与风险提示。
DolphinScheduler生产运维与故障排查
abstract 本文目标
- 建立从调度触发到外部作业结果的分层观测模型
- 设计元数据库、注册中心、Master、Worker 和告警组件的健康检查
- 按证据定位“未调度、未分发、执行失败、状态丢失”问题
- 建立升级、回滚、补数和灾备的生产门禁
前置阅读:DolphinScheduler核心概念与任务编排、监控告警与故障处理。
生产运行链路
一次工作流运行不是单一服务动作,可以按以下链路观察:
- 调度配置到时间后产生工作流实例;
- Master 解析 DAG 并生成可运行任务实例;
- 任务被分发到匹配的 Worker Group;
- Worker 准备租户身份、资源文件和插件环境;
- 任务插件提交 Shell、SQL、Spark、Flink 或其他外部作业;
- Worker 获取执行结果并更新任务实例;
- Master 汇总工作流状态并触发告警;
- 下游系统回读最终数据或文件结果。
排障时先确认链路断在哪一层,避免看到“任务失败”就直接重跑。
关键组件与健康信号
| 组件 | 应观察的信号 | 常见风险 |
|---|---|---|
| API Server | 请求成功率、延迟、认证失败 | UI可打开但写操作失败 |
| Master | 存活节点、队列积压、实例处理耗时 | DAG不推进、容错切换异常 |
| Worker | 存活节点、线程池、任务负载、磁盘 | 任务长期等待或执行环境不一致 |
| Alert Server | 发送成功率、插件错误、端到端收件 | 主流程失败但无人收到通知 |
| 元数据库 | 连接数、延迟、容量、备份状态 | 状态写入失败、页面查询缓慢 |
| 注册中心 | 会话、节点、选主和网络 | Master/Worker发现异常 |
| 资源中心 | 上传下载、权限、空间和一致性 | 脚本/JAR找不到或版本错乱 |
UI 首页可访问只能说明 API 与前端的部分链路正常,不能替代组件级健康和真实任务验证。
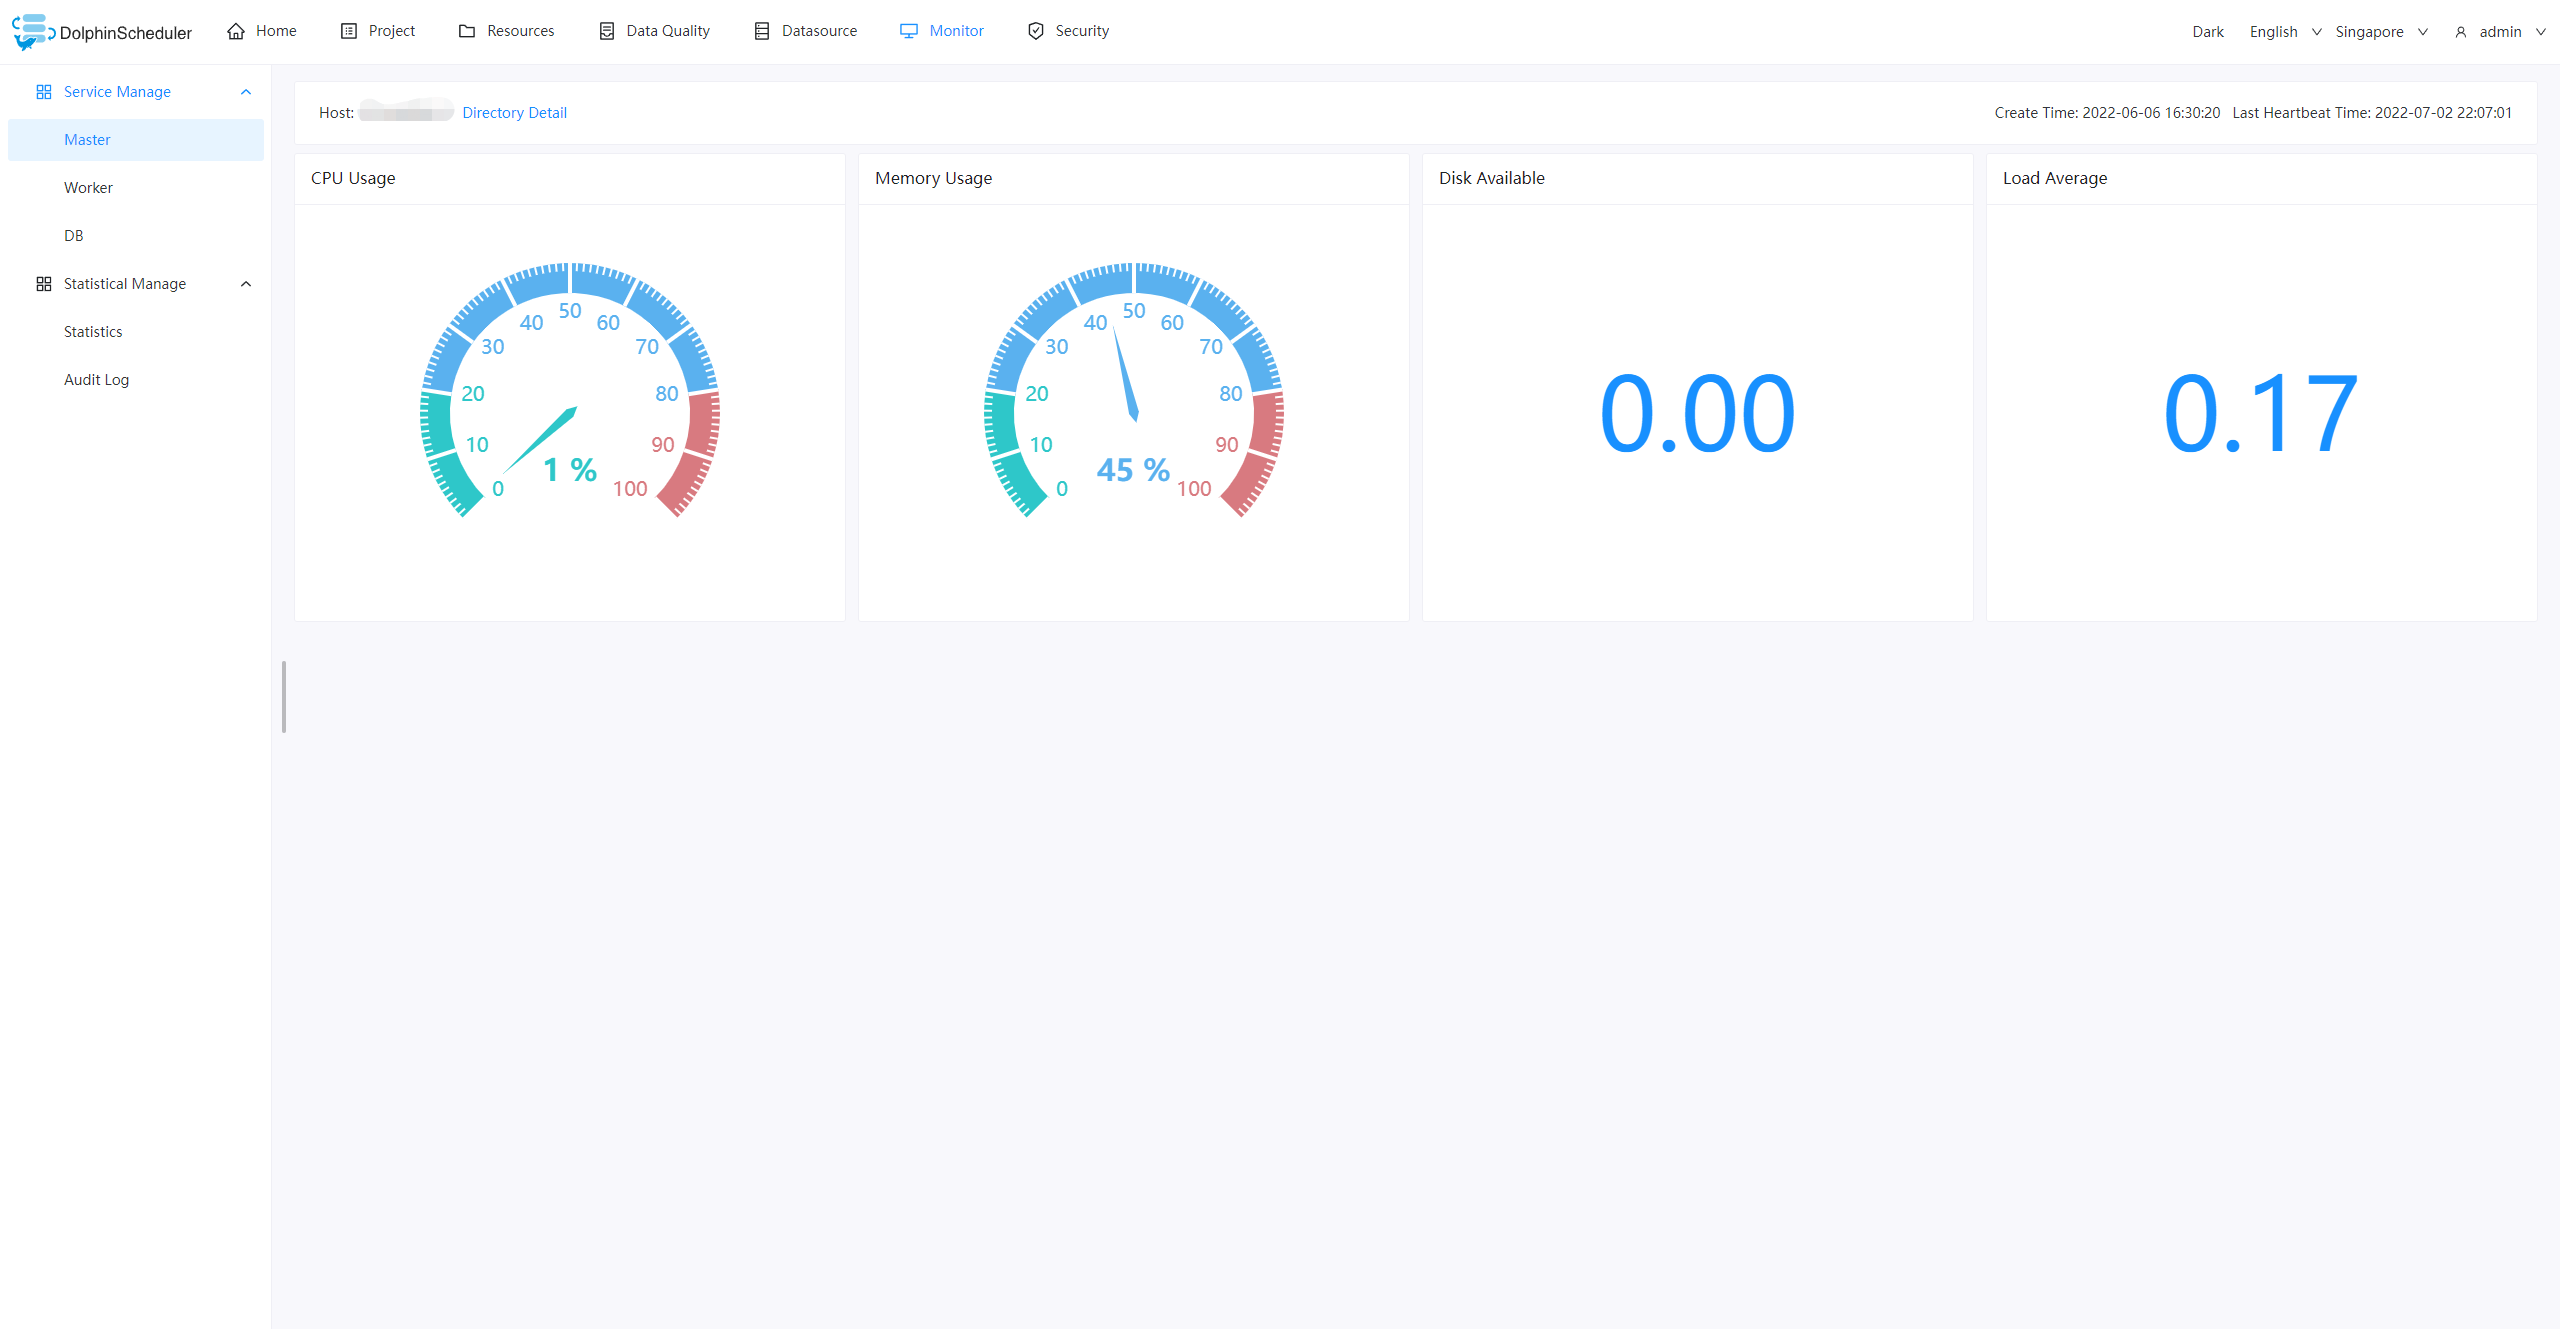
note 官方截图说明
图中是官方仓库展示的服务监控界面:当前选中 Master,并展示某个节点的 CPU、内存、磁盘可用空间和负载;左侧菜单还提供 Worker 与 DB 入口。这张图只用于识别监控入口和主机资源概览,不能替代任务积压、告警送达或端到端业务验证。图片来自 Apache DolphinScheduler 3.4.2 官方仓库的 monitor.png,按 Apache-2.0 许可引用。截图里的时间与数值只是官方示例,不应作为当前版本能力或生产阈值。

告警要做端到端验收
告警配置完成后,至少主动制造一次隔离环境失败:
echo "intentional failure for alert verification" >&2
exit 23
预期结果:
- 任务实例以失败状态结束;
- 工作流按配置的失败策略结束;
- Alert Server 产生发送记录;
- 目标群组或邮箱收到包含项目、工作流、任务和实例链接的消息;
- 值班人员能从消息回到对应日志。
仅在配置页看到告警组,不表示外部渠道可用。凭据过期、网络出口、群机器人限制和收件规则都可能让最后一公里失败。
分层排障流程
到点没有产生工作流实例
检查顺序:
- 工作流定义是否上线;
- 定时配置是否存在且已上线;
- Cron、时区、起止时间是否正确;
- Master 是否有存活节点;
- 调度日志是否生成触发记录。
有工作流实例但任务一直等待
重点检查 DAG 上游状态、Worker Group 是否有活跃节点、租户和队列是否可用、任务组并发是否已满。不要先增加重试次数;等待通常是调度或资源问题,不是执行失败。
Shell或SQL任务启动即失败
检查 Worker 上的实际执行用户、工作目录、环境变量、插件依赖、数据源连接和权限。把 UI 中配置的命令复制到同一 Worker、同一用户环境验证,不能在开发者电脑上成功就判定服务端环境正常。
外部Spark/Flink作业已提交但实例状态异常
区分“提交命令成功”和“远端作业成功”。记录 Application ID 或 Job ID,并同时检查外部引擎状态。如果调度器与外部引擎状态不一致,应先保留证据,确认是否存在回调、网络、超时或轮询异常,再决定重跑。
补数导致告警风暴或重复写入
补数前明确日期范围、并发、目标分区、幂等策略和计划内告警规则。补数完成后恢复告警,并执行跨日期完整性检查。不能因为是计划内补数就永久关闭失败告警。
重试、恢复与幂等
自动重试适合短暂网络失败和资源暂不可用,不适合权限、语法、数据质量或业务规则错误。每个可重试任务都应说明:
- 重复执行是否产生重复数据;
- 已完成一半时如何恢复;
- 超时后外部作业是否仍在运行;
- 哪个状态是事实来源;
- 什么时候停止自动重试并转人工。
MERGE INTO target_orders AS t
USING staging_orders AS s
ON t.order_id = s.order_id
WHEN MATCHED THEN UPDATE SET *
WHEN NOT MATCHED THEN INSERT *;
预期结果:这段 MERGE 展示按 order_id 匹配更新或插入的写法。只有在输入数据按该键不重复、目标表已有业务键唯一,且实际引擎的匹配与并发写入语义符合预期时,重复执行才可避免新增重复业务主键。UPDATE SET * 和 INSERT * 的语法支持情况也需按实际数据库或湖仓引擎验证。
容量与隔离
生产容量规划至少覆盖:
- 每分钟工作流与任务实例峰值;
- Master 和 Worker 线程池、队列积压;
- 单任务 CPU、内存、磁盘和网络消耗;
- 元数据库写入与历史数据增长;
- 资源中心文件体积和下载并发;
- 告警渠道的频率限制。
Worker Group 可以隔离不同任务,但还要结合外部队列、容器限额和数据库连接池。高优先级不等于无限资源,也不应让低优先级任务永久饥饿。
升级与回滚门禁
- 阅读目标版本 Release Notes 和升级文档;
- 备份元数据库、配置、密钥引用和资源中心;
- 在隔离环境复制关键工作流;
- 验证任务插件、数据源、告警、租户和 API;
- 演练停止写入、升级、验证和回滚;
- 小流量升级并观察完整调度周期;
- 确认数据库迁移是否可逆,再决定回滚路径。
新版本服务进程启动、页面返回 200 或数据库脚本执行成功,都不能单独代表升级完成。必须跑真实任务并回读业务结果。
备份与灾备
需要纳入备份的对象包括元数据库、资源中心、配置文件、证书与密钥引用、告警配置,以及外部依赖清单。工作流 JSON 导出可以作为补充,但不能替代一致的元数据库备份。
灾备演练应验证:
- 恢复后项目、工作流和定时配置完整;
- 敏感凭据能够重新挂载;
- 租户与 Worker Group 映射正确;
- 恢复期间错过的调度有明确补偿策略;
- 告警链路重新可用。
生产检查清单
- [ ] 默认账号和密码已替换
- [ ] 元数据库已备份并完成恢复演练
- [ ] Master、Worker、注册中心均有组件级监控
- [ ] 每类核心任务至少做过一次失败告警验收
- [ ] 重试任务已验证幂等性
- [ ] 补数有并发、日期和质量门禁
- [ ] 外部作业 ID 能从任务日志追溯
- [ ] 升级前有兼容矩阵和回滚检查点
学习连接
- DolphinScheduler概述与对比
- DolphinScheduler部署与首次工作流
- Airflow监控告警与故障处理
- Airflow最佳实践与踩坑
- Spark学习路线图
- Flink学习路线图
- DataX学习路线图
- Kafka学习路线图
- 批处理架构
- 实时处理架构