事实核验:2026-08-16 · 状态:维护中
记录仅说明核验时间与维护状态,不保证适用于所有环境;使用前请留意正文中的版本、适用条件与风险提示。
warning 适用范围与待维护事项
本文限于 Apache DolphinScheduler 3.4.2 的隔离单机体验,不是生产部署手册。运行前需按对应版本文档确认 JDK、租户对应的 Linux 用户及执行权限,正文未给出这些完整配置步骤。三个 Shell 节点须在同一主机顺序执行,固定 /tmp 文件不可用于并发实例或多 Worker 数据传递;重跑前应清理残留文件。外部数据库练习还需补充驱动、连接和初始化配置。示例须应用遇错退出修正,不能仅凭 validation=passed 判定成功。
DolphinScheduler部署与首次工作流
abstract 本文目标
- 区分 Standalone、伪集群、集群与 Kubernetes 部署
- 用 Standalone 完成一次本地功能体验
- 创建包含依赖关系的第一个 Shell 工作流
- 用实例状态、任务日志和输出验证运行结果
前置阅读:DolphinScheduler概述与对比、Linux学习路线图。
选择部署模式
官方 3.4.2 文档明确把 Standalone 定位为快速体验环境,而不是生产部署。选择模式时先看验证目标:
| 模式 | 适合目标 | 不应承担的任务 |
|---|---|---|
| Standalone | UI体验、少量工作流、概念验证 | 生产高可用、大规模任务 |
| 伪集群 | 单机验证多服务组件和配置 | 节点故障演练、容量验证 |
| 集群 | 多节点生产部署 | 未完成数据库、注册中心和权限设计的临时试跑 |
| Kubernetes | 容器平台上的弹性与标准化交付 | 尚无 K8s 运维能力的团队 |
官方 Standalone 文档建议少于 20 个工作流,并说明默认使用内存 H2 与测试用 ZooKeeper;重启后默认元数据可能丢失。需要持久化时应改用外部 MySQL 或 PostgreSQL,并完成元数据库初始化。
环境准备
以下步骤以官方 3.4.2 标签文档为依据。先准备官方要求的 JDK,并核对下载页中的二进制包和校验信息。
java -version
echo "$JAVA_HOME"
预期结果:能输出受当前版本支持的 Java 版本,JAVA_HOME 指向实际安装目录。正式部署前还要确认操作系统、数据库、注册中心和任务插件的版本要求。
warning 租户与系统用户
DolphinScheduler 的多租户执行涉及 Linux 用户切换。不要为了“先跑起来”在生产环境复制宽泛的免密 sudo 配置;应按企业安全基线限制部署用户、可切换用户和允许执行的命令。
启动Standalone
下载并校验官方二进制包后,解压到实验目录:
tar -xvzf apache-dolphinscheduler-3.4.2-bin.tar.gz
cd apache-dolphinscheduler-3.4.2-bin
chmod -R 755 .

bash ./bin/dolphinscheduler-daemon.sh start standalone-server
bash ./bin/dolphinscheduler-daemon.sh status standalone-server
预期结果:状态命令显示 Standalone Server 正常运行,浏览器可以访问 http://localhost:12345/dolphinscheduler/ui。
官方示例初始账号是 admin,初始密码是 dolphinscheduler123。它只用于隔离实验环境;首次登录后应立即修改,且不要把实验凭据暴露到公网。
停止服务:
bash ./bin/dolphinscheduler-daemon.sh stop standalone-server
创建项目与工作流
登录后按以下顺序操作:
- 创建项目,例如
learning-lab。 - 进入“项目管理 → 工作流 → 工作流定义”。
- 创建工作流并拖入三个 Shell 节点。
- 配置依赖关系:
extract → transform → validate。 - 保存工作流,检查执行类型与全局参数。
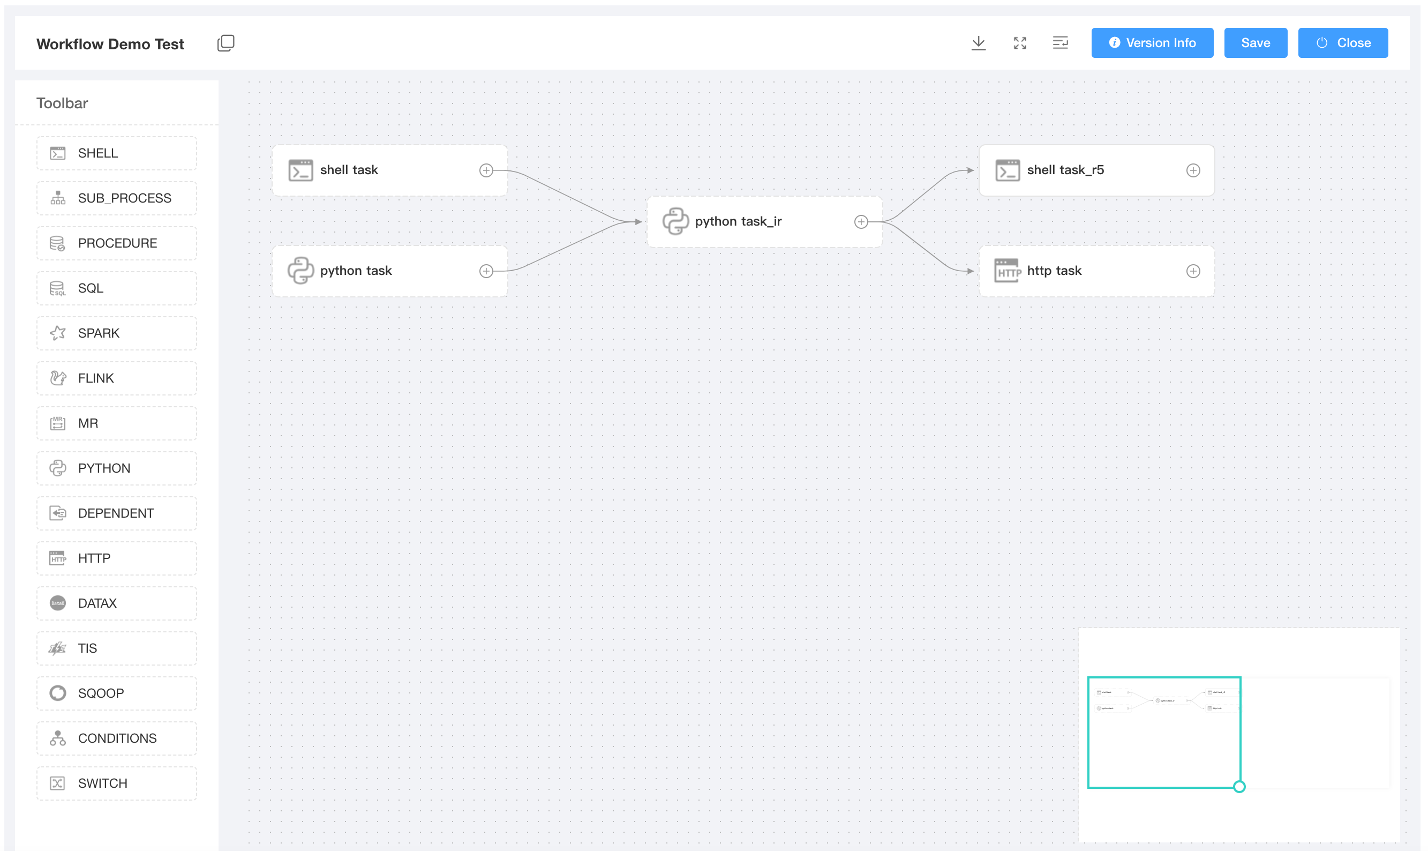
note 官方截图说明
图中是官方提供的混合任务 DAG 界面示例,用于识别任务类型工具栏、DAG 画布、依赖线和缩略图;其中包含 Shell、Python 和 HTTP 等任务,并不是本文 extract → transform → validate 三个 Shell 节点的最终结果。图片来自 Apache DolphinScheduler 3.4.2 官方仓库的 workflow-definition.png,按 Apache-2.0 许可引用。界面会随小版本、语言和插件组合变化,实际操作以当前部署为准。

三个任务可以使用可观察输出:
# extract
set -e
echo "rows=3" > /tmp/ds_orders.txt
cat /tmp/ds_orders.txt
# transform
set -e
test -s /tmp/ds_orders.txt
sed 's/rows=/processed_rows=/' /tmp/ds_orders.txt > /tmp/ds_result.txt
cat /tmp/ds_result.txt
# validate
set -e
grep -q '^processed_rows=3$' /tmp/ds_result.txt
echo "validation=passed"
预期结果:三个任务按依赖顺序执行,最后一个任务日志输出 validation=passed。如果文件不存在或内容不匹配,Shell 应返回非零退出码,使任务明确失败。
上线、运行与调度
官方工作流定义文档区分“编辑、上线、运行和定时”:
- 离线工作流可编辑,但不能按调度运行。
- 上线工作流可运行,并可配置定时。
- 新建定时配置后,还要把定时本身上线才会生效。
- 手工运行会创建工作流实例,实例下再产生任务实例。
首次学习建议先手工运行,观察结果稳定后再添加 Cron。不要同时修改工作流、上线调度并补数,否则失败时很难区分定义、参数还是调度窗口的问题。
运行验收
至少检查四层证据:
- 工作流实例:总体状态为成功,起止时间合理。
- 任务实例:三个任务均成功,依赖顺序正确。
- 任务日志:包含输入、输出和最终验证标记。
- 副作用:
/tmp/ds_result.txt的内容与预期一致。
仅看到 Web UI 中工作流“已上线”不表示执行成功;仅看到最终文件也不能证明调度依赖和任务状态正确。
从体验环境迁移到生产前
- 切换外部元数据库并演练备份恢复;
- 使用集群或 Kubernetes 部署,不保留 Standalone H2;
- 按任务类型下载并启用所需插件,避免加载无用插件;
- 配置租户、Worker Group、队列和资源中心;
- 配置告警并验证失败通知链路;
- 限制默认账号、修改初始密码并接入认证体系;
- 设计日志、指标、注册中心和元数据库监控;
- 在隔离环境完成升级与回滚演练。
练习
- 把
transform任务改为失败,观察下游任务和失败策略。 - 为工作流增加全局参数,在三个 Shell 任务中读取。
- 配置串行等待与并行两种执行类型,比较重叠实例行为。
- 把 Standalone 元数据库切换到外部数据库,再验证重启后的工作流定义。
学习连接
- DolphinScheduler核心概念与任务编排
- DolphinScheduler生产运维与故障排查
- 工作流调度概述
- Airflow安装部署
- Airflow第一个DAG
- 任务依赖与编排
- DataX学习路线图
- Spark学习路线图
- Flink学习路线图